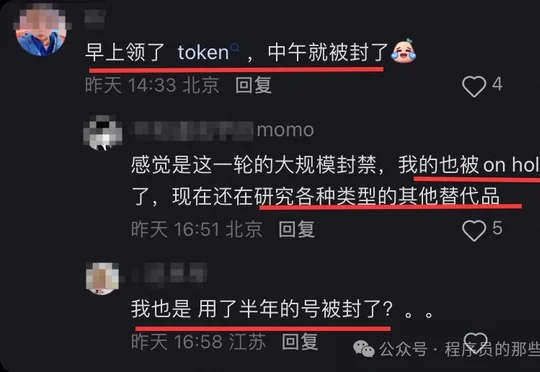
早上刚薅 Claude 羊毛,中午就喜提封号。网友调侃:A 社钓鱼执法
早上刚薅 Claude 羊毛,中午就喜提封号。网友调侃:A 社钓鱼执法Claude推出绑定GitHub即可领取限时云端额度的福利后,多名通过非官方渠道使用的国内用户在领取后不久因违反支持地区政策被封号,被网友调侃为"A社钓鱼执法"。
来自主题: AI资讯
10784 点击 2026-09-26 23:03

 搜索
Claude推出绑定GitHub即可领取限时云端额度的福利后,多名通过非官方渠道使用的国内用户在领取后不久因违反支持地区政策被封号,被网友调侃为"A社钓鱼执法"。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
前OpenAI研究员、TypeSafe CEO Diogo Almeida在播客访谈中批评Codex和Claude Code仍停留在AI辅助人类的阶段,称"Jev出现前的AI世界是个悲剧",并推出采用RLCD训练的System 1模型Jev,旨在让代码直接可靠调用AI判断,实现每美元智能最优。
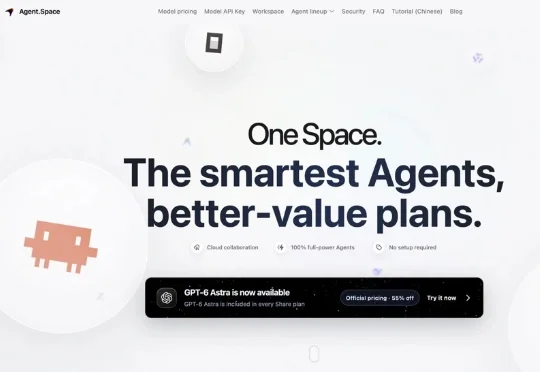
Agent Space作为汇集顶级Agent的云端工作空间,支持Claude Code、CodeX、OpenCode等本地工具接入云端运行,并可直接使用Opus 5.5、GPT-6 Sol、GPT-6 Luna及GPT-6 Astra等最新模型,其订阅额度还能同步接入本地Agent使用,降低了高价AI模型的使用门槛。
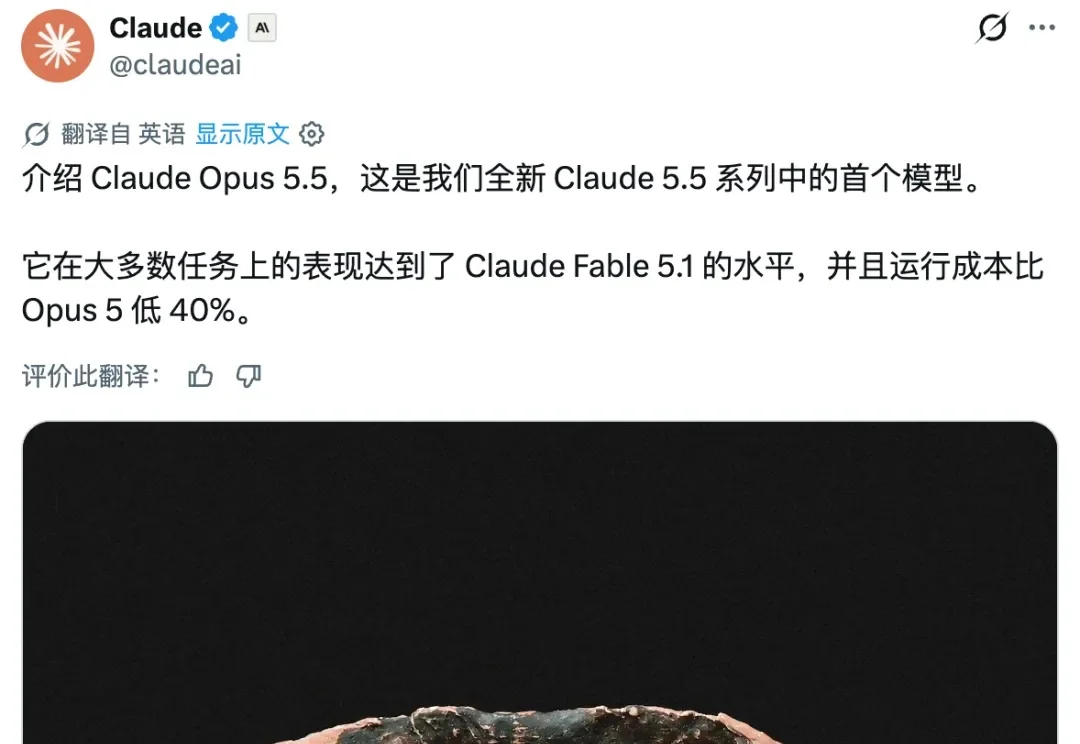
九月的新模型像下饺子一样接连登场,却大多只来得及各领风骚一两天,很快又被下一款抢走风头。
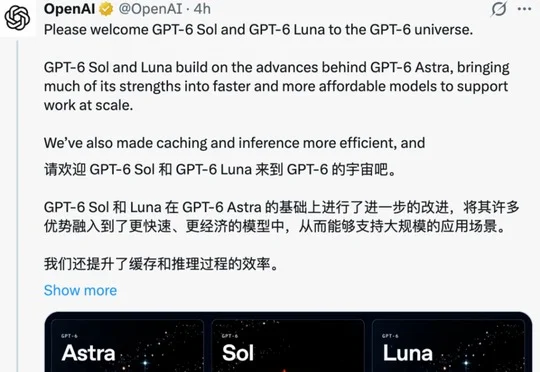
OpenAI同日发布GPT-6 Sol与GPT-6 Luna,API价格相比GPT-5.6腰斩50%,主打单位任务成本优势;Anthropic推出Claude Opus 5.5,典型任务成本降低约40%且输出速度提升超30%,两家厂商围绕"性价比"展开直接竞争。
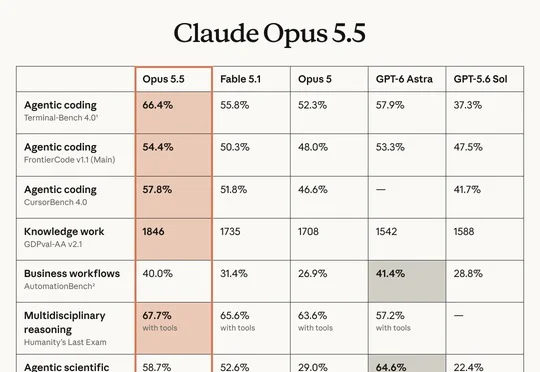
Anthropic发布Claude Opus 5.5,性能追平Fable 5.1且成本降低40%,在Terminal-Bench 4.0和GDPval-AA v2.1等多项基准测试中超越GPT-6 Astra,OpenAI两小时内推出GPT-6 Sol和Luna迎战。
Anthropic这回,怕不是憋了个大的?
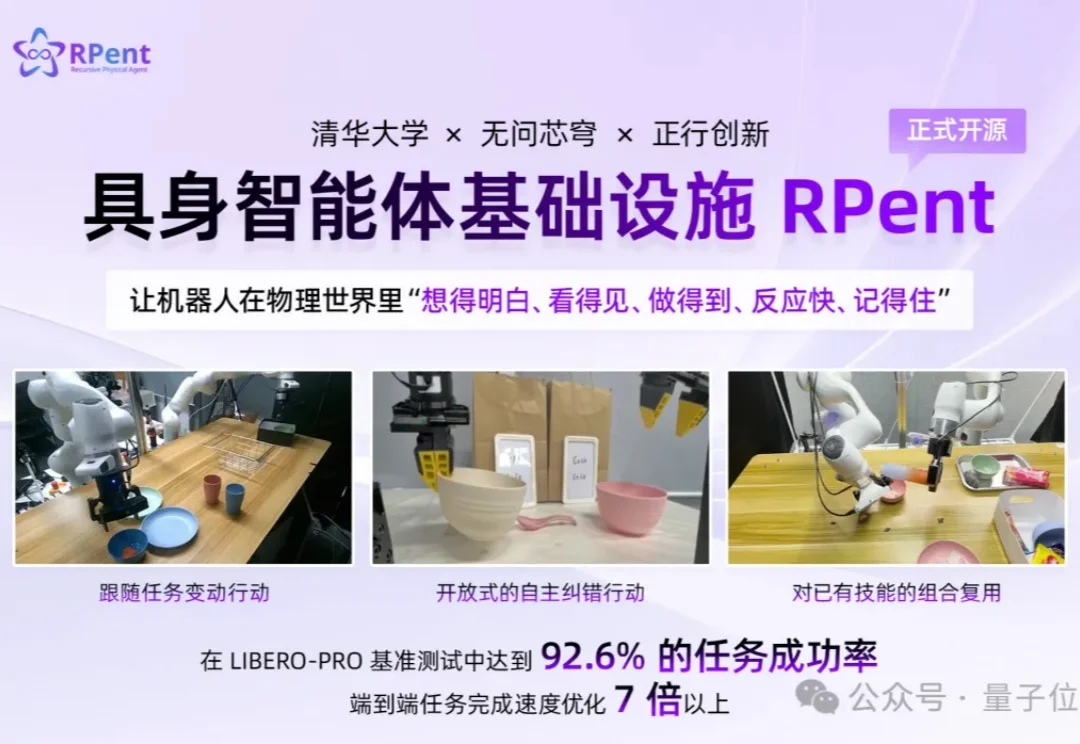
Codex、Claude Code等数字世界智能体,已经向我们展示出了一种全新且高效的工作方式:大模型理解目标,拆解任务,调用适当的工具,并根据执行结果不断调整计划,直到完成任务。
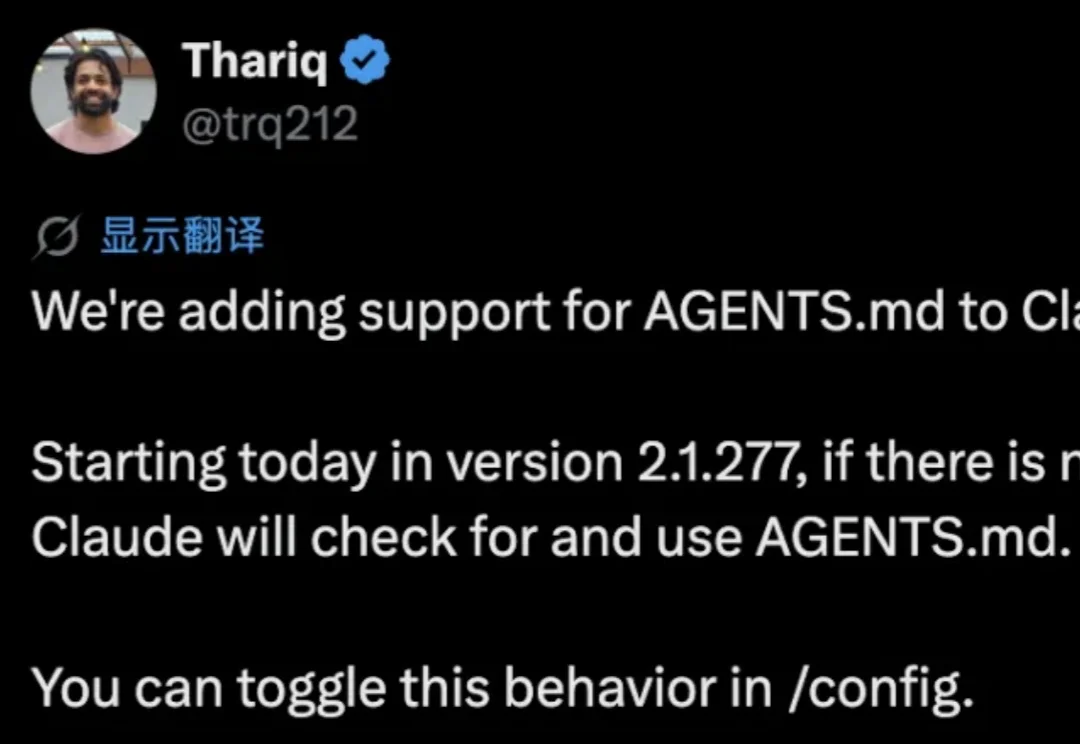
Claude向OpenAI格式投降了。